
oMLX
Server de inferență LLM nativ pe macOS pentru Apple Silicon, cu cache pe SSD care scurtează așteptarea.
Deschide oMLXomlx.ai
Ce face
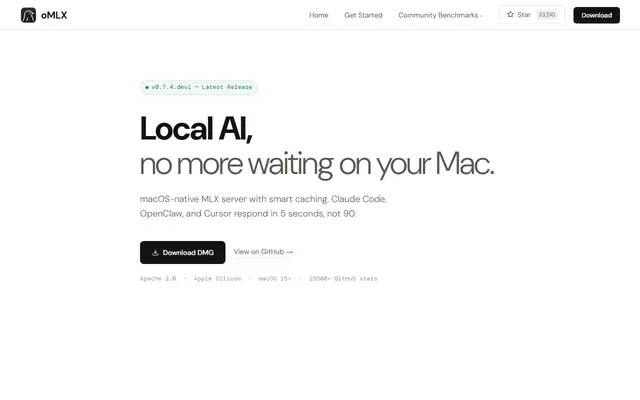
oMLX rulează modele de limbaj local pe Mac, pe baza MLX. Cache-ul paginat pe SSD reduce timpul până la primul răspuns al agenților de la 30-90 secunde la sub 5. Oferă API compatibil OpenAI și Anthropic și se folosește cu unelte precum Claude Code sau Cursor.
La ce îl folosești
- Dezvoltatori care rulează modele local, fără cloud
- Agenți de cod mai rapizi pe Mac
- Echipe cu cerințe de confidențialitate
Funcții
- Server MLX nativ pe macOS
- Cache KV pe SSD
- API compatibil OpenAI și Anthropic
- Batching pentru throughput
- Benchmark-uri comunitare
- Licență Apache 2.0
Cât costă
oMLX este gratuit. Licență Apache 2.0, cod pe GitHub; necesită Apple Silicon și macOS 15+.
Preț verificat la 10 noiembrie 2026 pe omlx.ai. Prețurile se schimbă des: uită-te și pe pagina lor.
Surse: omlx.ai. Fișă verificată la 10 noiembrie 2026.


